estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/correlacion-de-pearson
Coeficiente de correlación de Pearson
La medida estándar de asociación lineal entre dos variables cuantitativas: qué mide exactamente y qué no detecta.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Definición
El coeficiente de correlación de Pearson es la covarianza estandarizada:
La misma cuenta, escrita con los valores estandarizados de cada variable, deja ver qué suma:
Cada caso aporta el producto de sus dos puntajes . Los que están del mismo lado de la media en las dos variables —arriba y arriba, o abajo y abajo— suman; los que están en cuadrantes opuestos restan. El signo de dice cuál de los dos grupos pesa más.
2 · Sus propiedades
Va de −1 a +1. Los extremos son relación lineal perfecta; el 0, ausencia de relación lineal.
No tiene unidades, así que se puede comparar entre pares de variables distintas.
Es simétrico: . No distingue explicativa de respuesta.
No cambia con transformaciones lineales. Medir el ingreso en pesos o en miles de pesos da el mismo . Si la transformación multiplica por un número negativo, cambia solo el signo: el valor absoluto se mantiene. Pero sí cambia con transformaciones no lineales: tomar logaritmos da otro coeficiente. A Spearman eso no le pasa con las transformaciones monótonas crecientes, como el logaritmo, porque no alteran el orden de los casos.
Está atado a la recta de regresión. La pendiente de la recta de mínimos cuadrados es : el mismo convertido a las unidades de las variables. Ver recta de mínimos cuadrados.
Es sensible a los valores atípicos. Un solo punto extremo puede cambiarlo drásticamente, en cualquier dirección.
3 · Qué mide exactamente
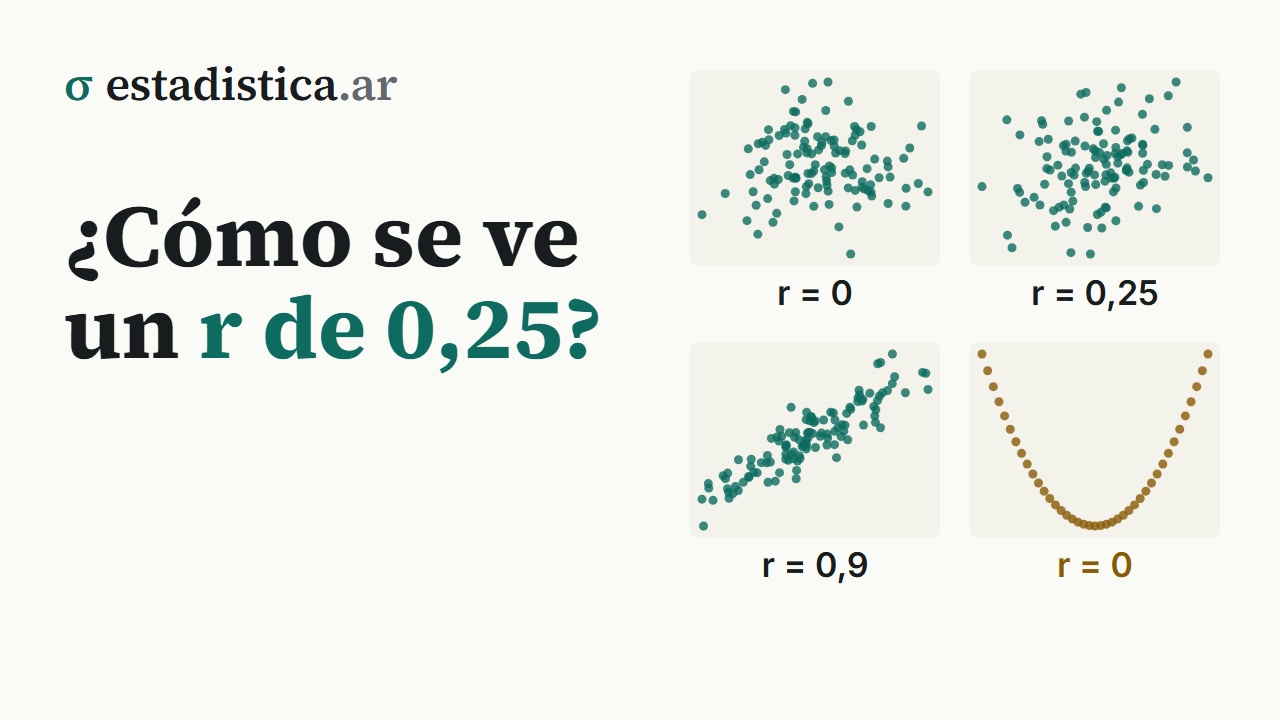
Relación lineal, y solo lineal. Es la limitación central y la fuente de casi todos los errores de interpretación.
Por eso el diagrama de dispersión va primero: el resume la nube en un número, y muchas nubes distintas dan el mismo número.
4 · Un ejemplo que muestra el problema
Entre horas trabajadas e ingreso mensual, en 14.212 ocupados de la EPH:
| Medida | Valor |
|---|---|
| Pearson | 0,249 |
| Spearman | 0,411 |
| Pearson sobre | 0,431 |
Los tres describen la misma relación, y Pearson da bastante menos por dos razones que se suman:
- La forma no es una recta. El ingreso mediano sube con fuerza hasta unas 40 horas semanales y después se aplana.
- El ingreso tiene una cola larga de valores extremos, y Pearson los pesa de lleno. Sacando el 1 % de ingresos más altos, pasa de 0,249 a 0,331.
Al tomar logaritmos se atenúan las dos cosas a la vez y llega a 0,431, casi el valor de Spearman.
Las correlaciones del ejemplo están calculadas sin ponderar, tratando la muestra como aleatoria simple.
5 · Tres cosas que cambian el valor sin que cambie la relación
Antes de comparar dos correlaciones —entre estudios, entre grupos, entre períodos— conviene descartar que la diferencia venga de acá:
Restricción de rango. Si se analiza solo una parte del recorrido de una variable, la correlación baja. El caso clásico es el examen de ingreso: entre todos los postulantes, la nota de admisión predice razonablemente el desempeño posterior; calculada solo entre los admitidos —que son los de notas altas— la correlación se desploma, y eso se usa a veces para decir que el examen “no sirve”. El examen no cambió: cambió el rango.
El efecto también funciona al revés: quedarse solo con los dos extremos —el cuarto inferior y el superior, descartando el medio— infla la correlación. En la misma nube de la figura, con todos da 0,60; solo con el cuarto superior, 0,40; con los dos cuartos extremos, 0,73. Los diseños de “grupos extremos” exageran la relación por esta vía.
Error de medición. Cualquier ruido en la medición de una de las dos variables atenúa la correlación hacia cero. Dos instrumentos poco fiables pueden mostrar una relación débil aunque los conceptos estén fuertemente relacionados; por eso en psicometría se informa la fiabilidad junto con las correlaciones. Con las dos fiabilidades se puede estimar la correlación que habría sin error de medición, la corrección por atenuación:
Con y fiabilidades de 0,70 y 0,80, la corregida es 0,53.
Nivel de agregación. La correlación entre promedios de grupos suele ser mucho más alta que entre individuos, porque promediar borra la variabilidad interna. Una correlación de 0,3 entre personas puede ser de 0,8 entre departamentos con los mismos datos. No son comparables, y leer la segunda como si hablara de personas es falacia ecológica.
6 · Sus supuestos
Para que describa bien:
- Las dos variables son cuantitativas. Con ordinales va Spearman.
- La relación es aproximadamente lineal.
- No hay atípicos dominantes.
- No hay subgrupos que se comporten distinto.
Para hacer inferencia sobre las exigencias no son las mismas para la prueba y para el intervalo:
- La prueba de es bastante robusta: con un grande funciona aunque los datos no sean normales.
- El intervalo con la de Fisher supone normalidad bivariada, y un grande no lo arregla: con colas pesadas su error estándar queda mal aunque haya miles de casos. Ahí conviene un intervalo por bootstrap.
Y las dos suponen muestreo aleatorio simple. Con una muestra por conglomerados, como la EPH, los errores estándar reales son más grandes. Ver el efecto de diseño.
7 · Significación e intervalo
La hipótesis nula es que no hay relación lineal en la población, , y se contrasta con un estadístico de grados de libertad:
El intervalo de confianza no se calcula directamente sobre , porque su distribución es asimétrica cerca de los extremos. Se pasa a la escala de Fisher, se construye el intervalo ahí y se vuelve:
Para el ejemplo, con da un intervalo de Fisher de 0,234 a 0,264. Pero el ingreso está muy lejos de la normalidad, y el intervalo por bootstrap —remuestrear los 14.212 casos 2.000 veces y quedarse con los percentiles 2,5 y 97,5— da 0,222 a 0,280: el doble de ancho.
La transformación sigue siendo la herramienta para promediar correlaciones de varios estudios o comparar dos entre sí.
8 · Errores frecuentes
- Concluir que no hay relación porque . Puede haber una curva.
- No graficar antes.
- Interpretarlo como porcentaje. Un de 0,5 no es “50 % de relación”; lo que se interpreta como proporción es , el coeficiente de determinación.
- Comparar correlaciones calculadas sobre rangos distintos o sobre distintos niveles de agregación.
- Usarlo con variables ordinales o categóricas.
- Calcularlo con atípicos sin analizarlos.
- Informar solo el valor p en muestras grandes, donde no distingue nada.
- Concluir causalidad. Ver correlación y causalidad.
- Promediar coeficientes de distintos grupos. No se promedian directamente: hay que pasar por la transformación z de Fisher, promediar ponderando por y volver.
- Informar el intervalo de Fisher con datos muy asimétricos. Sale más angosto de lo que corresponde; ahí va el bootstrap.
9 · En el software
# R — d: ocupados con ingreso (P21 > 0) y horas válidas (PP3E_TOT < 999)
horas <- d$PP3E_TOT; ingreso <- d$P21
cor(horas, ingreso)                        # 0.249
cor(horas, ingreso, use = "complete.obs")  # excluyendo faltantes
cor.test(horas, ingreso)                   # valor p e IC de Fisher: 0.234 a 0.264

cor(d[, c("PP3E_TOT", "P21")])             # matriz (solo columnas numéricas)

# Intervalo por bootstrap: 0.220 a 0.281 (cambia algo con la semilla)
set.seed(1)
rb <- replicate(2000, {
  i <- sample(length(horas), replace = TRUE)
  cor(horas[i], ingreso[i])
})
quantile(rb, c(0.025, 0.975))
# Python
import numpy as np
from scipy import stats
horas, ingreso = d["PP3E_TOT"], d["P21"]
res = stats.pearsonr(horas, ingreso)
res.statistic, res.pvalue
res.confidence_interval() # Fisher: 0.234 a 0.264
d[["PP3E_TOT", "P21"]].corr() # matriz
# Intervalo por bootstrap: 0.222 a 0.280
res.confidence_interval(method=stats.BootstrapMethod(
method="percentile", n_resamples=2000, rng=np.random.default_rng(1)))Excel: =COEF.DE.CORREL(rango1; rango2) (o =PEARSON, que da lo mismo)
SPSS: Analizar › Correlaciones › Bivariadas
(el mismo cuadro calcula también Kendall y Spearman)Herramientas de este tema
Seguir leyendo
Bioestadística · Fundamentos y descripción · 57 de 330
Estadística para Economía y Administración · Fundamentos y descripción · 56 de 318
Probabilidad y Estadística · Fundamentos y descripción · 56 de 302
Estadística para Ciencias Sociales · Fundamentos y descripción · 53 de 288
Estadística para la tesis · Los datos · 107 de 233
Cómo citar: Montivero, J. L. (2026). Coeficiente de correlación de Pearson. estadistica.ar. https://estadistica.ar/conceptos/correlacion-de-pearson
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Coeficiente de correlación de Pearson. estadistica.ar. https://estadistica.ar/conceptos/correlacion-de-pearson
BibTeX
@misc{estadistica_ar_correlacion_de_pearson,
  author       = {Montivero, Jorge Luis},
  title        = {{Coeficiente de correlación de Pearson}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/correlacion-de-pearson}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-11-09}
}
Última actualización: 9 de noviembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.