estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/correlacion-de-spearman
Correlación de Spearman
La correlación calculada sobre los puestos en vez de los valores: robusta a atípicos, válida con ordinales y capaz de detectar relaciones no lineales.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Qué es
La correlación de Spearman es la correlación de Pearson calculada sobre los puestos —el orden— en lugar de los valores originales.
La letra griega puede confundir: en otras entradas, es la correlación de Pearson en la población. Por eso muchos textos escriben la de Spearman como . Acá se mantiene , que es lo que muestran los programas.
Cuando no hay empates, existe una fórmula abreviada:
donde es la diferencia de puestos de cada caso. Con empates —que es lo habitual— hay que usar la definición general, y los puestos repetidos se reemplazan por el promedio de las posiciones que ocuparían. La abreviada pasa a ser una aproximación, que se aleja más cuanto más empates hay: en la EPH, con 14.212 casos y apenas 96 valores distintos de horas, da 0,413 en lugar de 0,411; en una escala Likert de cinco puntos la diferencia es mayor.
2 · Qué gana con eso
Detecta cualquier relación monótona, no solo la lineal. Si crece siempre que crece, aunque sea con una curva, Spearman da 1 y Pearson no. Da 1 solo si el orden es perfecto: un caso fuera de orden ya lo baja.
Es robusta a los valores extremos. Un ingreso de veinte millones pasa a ser “el puesto más alto”, igual que uno de tres millones: su peso desmesurado desaparece. En la EPH, sacar los diez ingresos más altos de 14.212 lleva a Pearson de 0,249 a 0,284; a Spearman, de 0,411 a 0,410. Lo que sí la afecta es un caso fuera de orden, y con pocos casos, uno solo pesa mucho.
Funciona con variables ordinales. Escalas Likert, niveles educativos, grados de severidad: todo lo que tenga orden pero no distancias interpretables.
No cambia si se transforma una variable de manera monótona. Tomar logaritmos, raíces o elevar al cuadrado valores positivos no altera el orden, así que no altera . Pearson, en cambio, da un número distinto con cada transformación.
No exige normalidad.
3 · El mecanismo, con seis casos
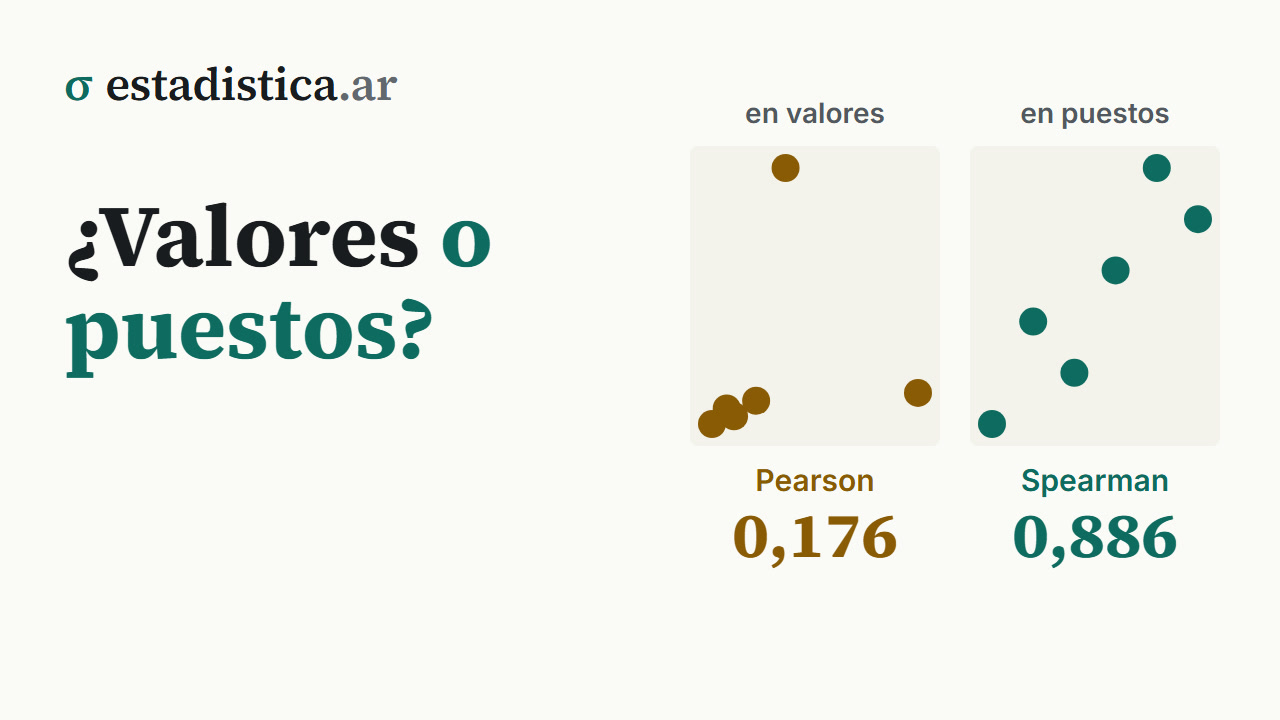
Antigüedad en el puesto y salario mensual de seis personas, donde la quinta gana mucho más que el resto:
| Antigüedad | Salario | Puesto de | Puesto de | ||
|---|---|---|---|---|---|
| 2 | 180 | 1 | 1 | 0 | 0 |
| 4 | 260 | 2 | 3 | −1 | 1 |
| 5 | 220 | 3 | 2 | 1 | 1 |
| 8 | 300 | 4 | 4 | 0 | 0 |
| 12 | 1.500 | 5 | 6 | −1 | 1 |
| 30 | 340 | 6 | 5 | 1 | 1 |
| 4 |
Y sobre los mismos seis pares, Pearson da 0,176.
Si se toman logaritmos del salario, Pearson sube a 0,308 —la transformación ayuda pero no alcanza— y Spearman sigue siendo 0,886, exactamente el mismo número. Esa insensibilidad es la propiedad que define al coeficiente.
Lo que deja a por debajo de 1 no es el salario de 1.500, sino los dos pares fuera de orden. Uno es el último caso: 30 años de antigüedad, mucho más que el resto, y un salario menor que el de 12 años.
4 · El ejemplo de la EPH
| Medida | Valor |
|---|---|
| Pearson sobre los valores | 0,249 |
| Spearman | 0,411 |
| Pearson sobre | 0,431 |
La diferencia entre 0,249 y 0,411 es grande, y es informativa: dice que la relación entre horas e ingreso es monótona pero no lineal, y que la asimetría extrema del ingreso estaba castigando a Pearson.
Son casos de la muestra, sin ponderar. Con el ponderador de ingresos
(PONDIIO), Spearman da 0,416 y Pearson 0,260: la lectura es la misma. El
intervalo de confianza del 95 % de va de 0,396 a 0,425.
Con una variable ordinal de verdad, el nivel educativo (de sin instrucción a universitario completo), y el ingreso: Spearman da 0,326 y Pearson 0,247. Pearson trata la distancia entre “primario completo” y “secundario incompleto” como si fuera un número; Spearman solo usa el orden.
5 · Qué pierde
Descarta la información de las distancias. Entre el primer y el segundo puesto puede haber un peso o un millón: Spearman no lo distingue.
Es menos potente si la relación realmente es lineal y los datos son normales. En ese escenario, Pearson aprovecha mejor la información.
No se interpreta como . El cuadrado de no es la proporción de variabilidad explicada de los valores: es la variación compartida entre los puestos, que es otra cosa.
No sirve para predecir. Sobre los puestos no se construye una recta útil: si lo que hace falta es una ecuación, hay que volver a los valores —transformados si es necesario— y usar regresión.
6 · Valor p e intervalo
Con muestras chicas, el valor p sale de la distribución exacta: todas las formas posibles de ordenar los puestos. Con muestras grandes se usa una aproximación. Los programas no siempre eligen igual, y con pocos casos la diferencia importa. Con los seis casos de arriba:
| Cálculo | Valor p |
|---|---|
Exacto (R, cor.test) | 0,033 |
Aproximación t (Python, stats.spearmanr) | 0,019 |
La aproximación da casi la mitad. R usa el exacto cuando no hay empates y hay menos de 1.290 casos; si hay empates, avisa que no puede y pasa a la aproximación. En Python, el exacto sale con una prueba de permutaciones (ver el código al final).
Para el intervalo de confianza se usa la transformación de Fisher, como en Pearson, pero con varianza en lugar de .
7 · Cuándo usar cada una
| Situación | Medida |
|---|---|
| Cuantitativas, relación lineal, sin atípicos | Pearson |
| Al menos una variable ordinal | Spearman |
| Relación monótona curva | Spearman |
| Atípicos que no se pueden justificar sacar | Spearman |
| Distribuciones muy asimétricas | Spearman, o Pearson sobre logaritmos |
| Muestra chica con empates | Kendall |
La tau de Kendall mide algo parecido, pero en otra escala: suele dar bastante menos. En los seis casos, contra ; en la EPH, 0,296 contra 0,411. No se comparan entre sí como si fueran el mismo número.
8 · Errores frecuentes
- Interpretar como proporción de variabilidad explicada.
- Usar la fórmula abreviada con muchos empates. Da un valor aproximado, que se aleja más cuanto más empates hay.
- Numerar los empates en vez de promediarlos, a mano o con
rank(x, ties.method = "first"). - Confiar en el valor p aproximado con pocos casos.
- Elegir la medida según cuál da más alto.
- Usar Spearman con variables nominales. Sin orden no hay puestos: ahí va V de Cramér.
- Esperar que cambie al transformar la variable. No cambia: esa es la idea.
- Creer que resuelve la causalidad. No cambia nada en ese plano.
- Olvidar que solo detecta relaciones monótonas. Una U sigue dando cerca de cero.
9 · En el software
# R
cor(x, y, method = "spearman")
cor.test(x, y, method = "spearman")     # con valor p

# Equivalencia: es Pearson sobre los rangos
cor(rank(x), rank(y))                   # idéntico
cor.test da el valor p exacto si no hay empates y hay menos de 1.290 casos;
con empates avisa y usa la aproximación.
# Python
from scipy import stats
rho, p = stats.spearmanr(x, y)          # p por aproximación t

# Con pocos casos, el p exacto por permutaciones
res = stats.permutation_test((x,), lambda a: stats.spearmanr(a, y)[0],
                             permutation_type="pairings")
res.pvalue

# pandas
datos[["x", "y"]].corr(method="spearman")
Excel: no tiene función propia. Con x en A2:A7 e y en B2:B7:
puestos =JERARQUIA.MEDIA(A2; $A$2:$A$7; 1) (y lo mismo para y)
rho =COEF.DE.CORREL(C2:C7; D2:D7) sobre los puestos
JERARQUIA.MEDIA promedia los empates; JERARQUIA.EQV no
SPSS: Analizar › Correlacionar › Bivariadas › marcar SpearmanHerramientas de este tema
- CalculadoraCorrelación y regresión simple
Seguir leyendo
Bioestadística · Fundamentos y descripción · 59 de 330
Estadística para Economía y Administración · Fundamentos y descripción · 58 de 318
Probabilidad y Estadística · Fundamentos y descripción · 58 de 302
Estadística para Ciencias Sociales · Fundamentos y descripción · 55 de 288
Estadística para la tesis · Los datos · 109 de 233
Cómo citar: Montivero, J. L. (2026). Correlación de Spearman. estadistica.ar. https://estadistica.ar/conceptos/correlacion-de-spearman
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Correlación de Spearman. estadistica.ar. https://estadistica.ar/conceptos/correlacion-de-spearman
BibTeX
@misc{estadistica_ar_correlacion_de_spearman,
  author       = {Montivero, Jorge Luis},
  title        = {{Correlación de Spearman}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/correlacion-de-spearman}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-11-10}
}
Última actualización: 10 de noviembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.