estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/curva-de-lorenz-y-gini
Curva de Lorenz y coeficiente de Gini
Cómo se mide la desigualdad de una distribución: la curva, el coeficiente que la resume y lo que ese único número no puede distinguir.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · La curva de Lorenz
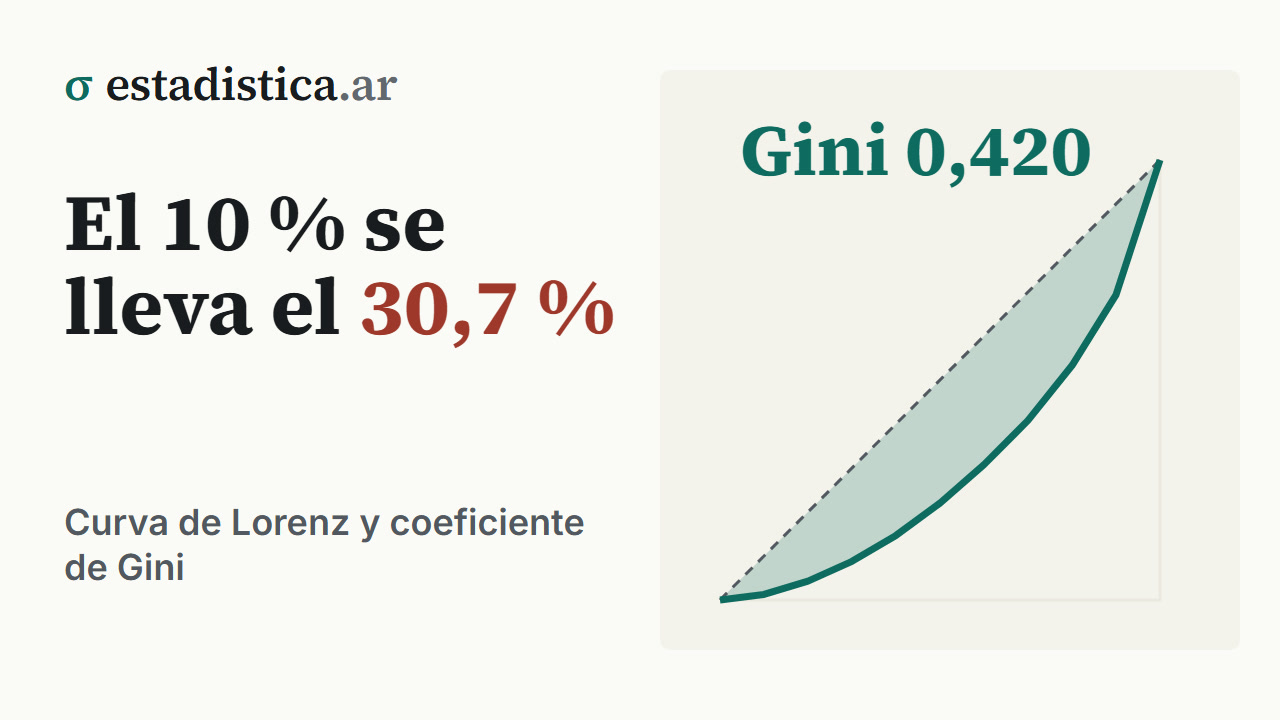
Relaciona la población acumulada, ordenada de menor a mayor ingreso, con el ingreso acumulado que concentra.
2 · El coeficiente de Gini
Equivale al doble del área entre las dos líneas, y va de 0 a 1:
| Significa | |
|---|---|
| 0 | igualdad perfecta: todos tienen lo mismo |
| 1 | concentración total: una persona tiene todo |
| 0,25 – 0,35 | desigualdad baja (países nórdicos) |
| 0,40 – 0,50 | desigualdad alta (América Latina) |
El 1 es un límite: con personas, el máximo posible es , que con miles de casos es prácticamente 1.
3 · Los diez deciles
El Gini del ejemplo es 0,420, y esta es la distribución que resume:
| Decil | % del ingreso | Decil | % del ingreso | |
|---|---|---|---|---|
| 1 | 1,3 % | 6 | 8,7 % | |
| 2 | 3,0 % | 7 | 10,1 % | |
| 3 | 4,5 % | 8 | 12,5 % | |
| 4 | 5,9 % | 9 | 16,1 % | |
| 5 | 7,4 % | 10 | 30,7 % |
| Indicador derivado | Valor |
|---|---|
| Razón decil 10 / decil 1 | 24,2 |
| Índice de Palma (decil 10 / deciles 1 a 4) | 2,1 |
4 · Lo que un solo número no puede distinguir
Un Gini de 0,40 puede corresponder a:
- Una sociedad con una élite muy rica y el resto parejo.
- Una sociedad con una base muy pobre y el resto parejo.
Las dos requieren políticas opuestas. Por eso el Gini se acompaña de:
| Medida | Qué agrega |
|---|---|
| Participación por deciles | dónde está concentrado |
| Razón 10/1 o 20/20 | la brecha entre extremos |
| Índice de Palma | decil 10 sobre los cuatro deciles más pobres |
| Índice de Theil | descomponible entre grupos y dentro de grupos |
Una transferencia desde arriba, en cambio, sí se nota, y más cuanto más abajo llega. Pasar el 1 % de la masa de ingresos del decil 10 al decil 1 lleva el Gini a 0,402; pasar la misma plata al decil 5, a 0,410. El Palma marca la diferencia con más claridad: de 2,09 a 1,90 en el primer caso y a 2,03 en el segundo.
5 · Sus otros usos
No es exclusivo de ingresos: se aplica a cualquier distribución donde importe la concentración.
- Tierra: concentración de la propiedad rural.
- Mercados: concentración de ventas entre empresas.
- Salud: distribución de recursos sanitarios entre regiones.
- Educación: años de escolaridad.
6 · Detalles de cálculo
Con datos agrupados —por deciles— el Gini se subestima, porque se pierde la desigualdad que hay adentro de cada grupo. Cuánto, con estos mismos datos:
| Cálculo | Gini |
|---|---|
| Con microdatos | 0,4199 |
| Con la tabla de diez deciles | 0,4094 |
Una centésima de diferencia, un 2,5 % menos, solo por trabajar con la tabla publicada en vez de con la base. Con quintiles en lugar de deciles la subestimación es mayor: 0,388, un 7,6 % menos.
Con ponderadores, como los de una encuesta, hay que usarlos: el cálculo simple
sobre casos sin ponderar da un valor distinto. Acá, 0,407 sin ponderar, 0,416 con
PONDERA —el ponderador general— y 0,420 con PONDIIO, el que el INDEC calibra
para el ingreso de la ocupación principal y el que corresponde usar.
Su error estándar no tiene fórmula sencilla: se estima por bootstrap.
7 · Errores frecuentes
- Comparar Gini de universos distintos: ingreso individual, familiar, per cápita, antes o después de impuestos.
- Interpretarlo como porcentaje. Un Gini de 0,42 no es “42 % de desigualdad”.
- Reportarlo solo, sin la participación por deciles.
- Calcularlo sobre datos agrupados y compararlo con uno de microdatos.
- Ignorar los ponderadores de la encuesta.
- Usar un intervalo que ignore el diseño muestral.
- Leer variaciones chicas como cambios reales: sin intervalo de confianza, una diferencia de 0,005 no significa nada.
8 · En el software
Con el archivo de personas de la EPH, usu_individual_T126.txt: ocupados
(ESTADO 1) con ingreso de la ocupación principal (P21) mayor que cero.
# R
ind <- read.table("usu_individual_T126.txt", sep = ";", dec = ",", header = TRUE)
oc  <- subset(ind, ESTADO == 1 & P21 > 0)

lorenz <- function(x, w) {
  o <- order(x); x <- as.numeric(x[o]); w <- as.numeric(w[o])   # sin overflow
  list(p = c(0, cumsum(w) / sum(w)),             # la curva arranca en el origen
       q = c(0, cumsum(w * x) / sum(w * x)))
}
gini <- function(x, w) {
  l <- lorenz(x, w)
  1 - sum((l$q[-1] + head(l$q, -1)) * diff(l$p))
}
gini(oc$P21, oc$PONDIIO)                          # 0,420

l <- lorenz(oc$P21, oc$PONDIIO)
plot(l$p, l$q, type = "l"); abline(0, 1)          # la curva y la diagonal
100 * diff(approx(l$p, l$q, xout = 0:10 / 10)$y)  # 1,3 ... 30,7

# El IC, por bootstrap de viviendas (CODUSU), no de personas
viv <- split(seq_len(nrow(oc)), oc$CODUSU)
set.seed(1)
b <- replicate(500, {
  i <- unlist(viv[sample(length(viv), replace = TRUE)], use.names = FALSE)
  gini(oc$P21[i], oc$PONDIIO[i])
})
gini(oc$P21, oc$PONDIIO) + c(-1, 1) * 1.96 * sd(b)  # 0,407 a 0,432

# Sin ponderar, con paquete: ineq::Gini(oc$P21) da 0,407
# Python
import numpy as np
import pandas as pd
ind = pd.read_csv("usu_individual_T126.txt", sep=";", decimal=",", low_memory=False)
oc = ind[(ind.ESTADO == 1) & (ind.P21 > 0)]
def lorenz(x, w):
o = np.argsort(x); x, w = x[o], w[o]
p = np.r_[0, np.cumsum(w) / w.sum()] # la curva arranca en el origen
q = np.r_[0, np.cumsum(w * x) / (w * x).sum()]
return p, q
def gini(x, w):
p, q = lorenz(x, w)
return 1 - np.sum((q[1:] + q[:-1]) * np.diff(p))
x, w = oc.P21.to_numpy(float), oc.PONDIIO.to_numpy(float)
print(gini(x, w)) # 0,420
p, q = lorenz(x, w)
print(100 * np.diff(np.interp(np.linspace(0, 1, 11), p, q))) # 1,3 ... 30,7Excel: ingreso ordenado de menor a mayor en A2:A15449, ponderador en B2:B15449
C2 =B2/SUMA(B$2:B$15449) y C3 =C2+B3/SUMA(B$2:B$15449)
D2 =A2*B2/SUMAPRODUCTO(A$2:A$15449;B$2:B$15449) y D3 =D2+ ...
Gini =1-C2*D2-SUMAPRODUCTO(D3:D15449+D2:D15448;C3:C15449-C2:C15448)
SPSS: SELECT IF ESTADO = 1 AND P21 > 0.
SORT CASES BY P21.
COMPUTE wx = PONDIIO * P21.
CREATE cw = CSUM(PONDIIO) /cwx = CSUM(wx).
AGGREGATE /OUTFILE=* MODE=ADDVARIABLES /tw = SUM(PONDIIO) /twx = SUM(wx).
COMPUTE p = cw / tw.
COMPUTE q = cwx / twx.
COMPUTE tramo = (q + LAG(q)) * (p - LAG(p)).
IF ($CASENUM = 1) tramo = q * p.
DESCRIPTIVES tramo /STATISTICS = SUM. Gini = 1 - la sumaHerramientas de este tema
- CalculadoraCurva de Lorenz y Gini
Seguir leyendo
Bioestadística · El dato en contexto · 98 de 330
Estadística para Economía y Administración · El dato en contexto · 101 de 318
Estadística para Ciencias Sociales · El dato en contexto · 88 de 288
Estadística para la tesis · Instrumento · 37 de 233
Cómo citar: Montivero, J. L. (2026). Curva de Lorenz y coeficiente de Gini. estadistica.ar. https://estadistica.ar/conceptos/curva-de-lorenz-y-gini
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Curva de Lorenz y coeficiente de Gini. estadistica.ar. https://estadistica.ar/conceptos/curva-de-lorenz-y-gini
BibTeX
@misc{estadistica_ar_curva_de_lorenz_y_gini,
  author       = {Montivero, Jorge Luis},
  title        = {{Curva de Lorenz y coeficiente de Gini}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/curva-de-lorenz-y-gini}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-11-18}
}
Última actualización: 18 de noviembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.