estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/probabilidad-condicional
Probabilidad condicional
Cómo cambia la probabilidad de un evento cuando ya se sabe que ocurrió otro: la idea que está detrás de casi toda la Estadística aplicada.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Definición
La probabilidad condicional de dado es la probabilidad de que ocurra sabiendo que ya ocurrió :
Por eso se divide por : es renormalizar, para que las probabilidades dentro del nuevo espacio vuelvan a sumar 1.
“Ya ocurrió” no quiere decir “ocurrió antes”. La condición es información, no tiempo: se puede condicionar por algo posterior, como en , donde el test viene después de la enfermedad.
Y la condicional es una probabilidad hecha y derecha: fijado , cumple los tres axiomas. Por eso todas las propiedades valen adentro de la condición, por ejemplo .
2 · Con datos reales
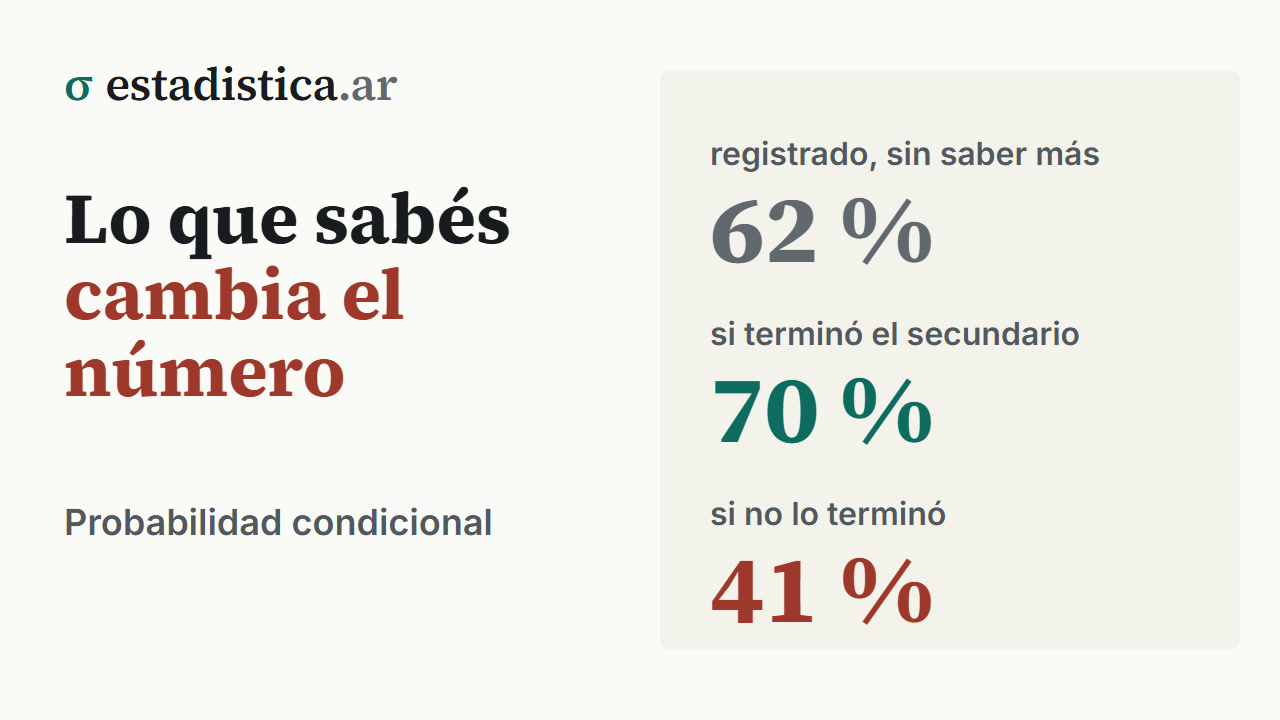
Entre los asalariados de la EPH, la probabilidad de tener empleo registrado es 0,6236. Pero si se sabe que la persona completó el secundario:
y si no lo completó:
Con los números tal como están escritos, la segunda cuenta da 0,4110; el 0,4109 sale de los valores sin redondear, y lo mismo pasa con alguna cifra de las tablas que siguen.
70 % contra 41 %. La información sobre la educación cambia sustancialmente lo que se puede decir sobre la registración. Cuando eso pasa, las variables están asociadas.
3 · Las dos direcciones, completas
La misma tabla se puede condicionar por fila o por columna, y son preguntas distintas. Vale la pena verlas juntas una vez:
Por fila — :
| No registrado | Registrado | Suma | |
|---|---|---|---|
| Sin secundario | 0,5891 | 0,4109 | 1,0000 |
| Con secundario | 0,3042 | 0,6958 | 1,0000 |
Por columna — :
| Sin secundario | Con secundario | Suma | |
|---|---|---|---|
| No registrado | 0,3968 | 0,6032 | 1,0000 |
| Registrado | 0,1670 | 0,8330 | 1,0000 |
4 · Cómo se lee la barra
se lee “probabilidad de dado ”, y conviene tener claro qué es cada cosa:
| Elemento | Papel |
|---|---|
| , a la derecha | lo que ya se sabe: la condición, el subgrupo |
| , a la izquierda | lo que se pregunta |
Invertir el condicionamiento sin darse cuenta es confundir la condicional con su inversa; en el contexto judicial, donde se toma la probabilidad de la evidencia si el acusado es inocente por la probabilidad de que sea inocente, se la llama falacia del fiscal. Es lo que el teorema de Bayes corrige.
5 · Cuánto mueve la condición
Comparar la condicional con la marginal dice cuánta información aporta saber :
| Cociente contra la marginal | ||
|---|---|---|
| Sin condicionar | 0,6236 | 1,000 |
| Dado secundario completo | 0,6958 | 1,116 |
| Dado secundario incompleto | 0,4109 | 0,659 |
6 · El caso que más discusión generó
Tres puertas, un premio detrás de una. El participante elige una, y el presentador —que sabe dónde está el premio— abre otra de las que quedan, siempre una vacía, y ofrece cambiar. Si el premio está en la elegida y las otras dos están vacías, elige al azar cuál abrir. ¿Conviene?
Conviene, y la respuesta es 2/3 contra 1/3. La clave está en qué información aporta la puerta abierta:
| Probabilidad inicial | Qué pasa al abrirse una puerta | |
|---|---|---|
| La elegida | 1/3 | no cambia: el presentador siempre podía abrir una vacía |
| Las otras dos, juntas | 2/3 | se concentra toda en la única que queda cerrada |
El “al azar” del enunciado también importa. Si el presentador tuviera una preferencia —abrir siempre la vacía de más a la izquierda, por ejemplo—, la puerta que abre daría información: según cuál abriera, cambiar ganaría con probabilidad 1/2 o 1.
7 · Dónde aparece, aunque no se la nombre
Esta es la razón por la que el concepto importa más de lo que su lugar en el programa sugiere:
- Los porcentajes por fila de una tabla cruzada son probabilidades condicionales. Ver frecuencias marginales y condicionales.
- La sensibilidad de una prueba diagnóstica es , y el valor predictivo es la condicional invertida.
- El valor p es , no al revés. Toda la confusión clásica sobre el valor p es un problema de condicional invertida.
- Un modelo de regresión estima : la media de condicional a los valores de las predictoras.
- El riesgo relativo es un cociente de dos condicionales.
Las condiciones se pueden acumular: es la probabilidad de dentro del subgrupo donde ocurren y a la vez, y se calcula igual, dividiendo por . Agregar una condición puede cambiar la respuesta, e incluso darla vuelta: es la paradoja de Simpson.
8 · El camino inverso
Despejando de la definición se obtiene la regla del producto:
Es la misma igualdad leída al revés, y suele ser más útil: las condicionales —“de los que tienen secundario, el 70 % está registrado”— son lo que se conoce, y la conjunta lo que se busca.
9 · Errores frecuentes
- Invertir el condicionamiento. , y la diferencia puede ser enorme.
- Dividir por la conjunta en lugar de por la marginal.
- Olvidar que el espacio cambió. Dentro de las probabilidades se miden contra , y por eso hay que dividir.
- Sumar o promediar condicionales de subgrupos distintos. No dan el total; hay que ponderarlas.
- Condicionar por algo de probabilidad cero. La fórmula no está definida.
- Leer una condicional como causa. Que sea alta no prueba que el secundario cause la registración.
- Suponer que la asociación se mantiene dentro de cada subgrupo. Puede invertirse: ver paradoja de Simpson.
- Calcular condicionales de una encuesta sin ponderar. Se obtiene la proporción de casos de la muestra, no de personas: 0,4185 en lugar de 0,4109.
10 · En el software
Las dos tablas de la sección 3 desde la EPH del INDEC, con los ponderadores, y las tres puertas simuladas con los dos presentadores.
# R — condicionales desde la EPH del primer trimestre de 2026, ponderadas
zip <- tempfile(fileext = ".zip")
download.file("https://www.indec.gob.ar/ftp/cuadros/menusuperior/eph/EPH_usu_1_Trim_2026_txt.zip",
              zip, mode = "wb")
eph <- read.csv(unz(zip, "usu_individual_T126.txt"), sep = ";", dec = ",")
asal <- subset(eph, ESTADO == 1 & CAT_OCUP == 3 & CH06 >= 18 &
                    PP07H %in% 1:2 & NIVEL_ED %in% 1:6)
asal$educacion  <- ifelse(asal$NIVEL_ED %in% 4:6, "Con secundario", "Sin secundario")
asal$registrado <- ifelse(asal$PP07H == 1, "Registrado", "No registrado")

tab <- xtabs(PONDERA ~ educacion + registrado, asal)   # personas, no casos
round(prop.table(tab, 1), 4)    # por fila: P(registrado | educación), 0,6958 y 0,4109
round(prop.table(tab, 2), 4)    # por columna: P(educación | registrado)
rowSums(prop.table(tab, 1))     # control: cada fila suma 1

# Directo sobre los datos: una media ponderada dentro del subgrupo
con <- asal$educacion == "Con secundario"
weighted.mean(asal$registrado[con] == "Registrado", asal$PONDERA[con])   # 0,6958

# Sin ponderar da otro número: cuenta casos de la muestra
round(prop.table(table(asal$educacion, asal$registrado), 1), 4)          # 0,4185

# Las tres puertas, con los dos presentadores
set.seed(1)
n <- 200000
premio <- sample(1:3, n, replace = TRUE)            # el participante elige la 1
mean(premio != 1)                                   # sabe dónde está: cambiar gana 2/3
abre <- sample(2:3, n, replace = TRUE)              # abre al azar una de las otras
vacia <- abre != premio                             # solo las partidas en que salió vacía
mean(premio[vacia] != 1)                            # cambiar gana 1/2
# Python — lo mismo
import io
import urllib.request
import zipfile
import numpy as np
import pandas as pd
url = "https://www.indec.gob.ar/ftp/cuadros/menusuperior/eph/EPH_usu_1_Trim_2026_txt.zip"
pedido = urllib.request.Request(url, headers={"User-Agent": "Mozilla/5.0"})
z = zipfile.ZipFile(io.BytesIO(urllib.request.urlopen(pedido).read()))
eph = pd.read_csv(z.open("usu_individual_T126.txt"), sep=";", decimal=",", low_memory=False,
usecols=["ESTADO", "CAT_OCUP", "CH06", "PP07H", "NIVEL_ED", "PONDERA"])
asal = eph.query("ESTADO == 1 and CAT_OCUP == 3 and CH06 >= 18 "
"and PP07H in [1, 2] and NIVEL_ED in [1, 2, 3, 4, 5, 6]")
# Series con el índice de asal: si fueran arrays, crosstab desalinearía los pesos
educacion = asal.NIVEL_ED.isin([4, 5, 6]).map({True: "Con secundario", False: "Sin secundario"})
registrado = (asal.PP07H == 1).map({True: "Registrado", False: "No registrado"})
for margen in ["index", "columns"]: # por fila y por columna
print(pd.crosstab(educacion, registrado, values=asal.PONDERA,
aggfunc="sum", normalize=margen).round(4))
print(pd.crosstab(educacion, registrado, normalize="index").round(4)) # sin ponderar: 0,4185
rng = np.random.default_rng(1)
n = 200_000
premio = rng.integers(1, 4, n) # el participante elige la 1
print((premio != 1).mean()) # sabe dónde está: 2/3
abre = rng.integers(2, 4, n) # abre al azar una de las otras
vacia = abre != premio
print((premio[vacia] != 1).mean()) # 1/2Herramientas de este tema
- CalculadoraProbabilidad y teorema de Bayes
Seguir leyendo
Bioestadística · Azar y modelos · 105 de 330
Estadística para Economía y Administración · Azar y modelos · 108 de 318
Probabilidad y Estadística · Azar y modelos · 87 de 302
Estadística para Ciencias Sociales · Azar y modelos · 95 de 288
Estadística para la tesis · El análisis · 123 de 233
Cómo citar: Montivero, J. L. (2026). Probabilidad condicional. estadistica.ar. https://estadistica.ar/conceptos/probabilidad-condicional
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Probabilidad condicional. estadistica.ar. https://estadistica.ar/conceptos/probabilidad-condicional
BibTeX
@misc{estadistica_ar_probabilidad_condicional,
  author       = {Montivero, Jorge Luis},
  title        = {{Probabilidad condicional}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/probabilidad-condicional}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-11-18}
}
Última actualización: 18 de noviembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.