estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/independencia-de-eventos
Independencia de eventos
Cuándo saber que ocurrió un evento no cambia nada sobre otro, cómo se verifica y por qué es el supuesto más frágil de la Estadística aplicada.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Definición
Dos eventos son independientes si saber que uno ocurrió no cambia la probabilidad del otro:
Equivalentemente, y es la forma que más se usa por ser simétrica:
2 · Cómo se verifica: las cuatro celdas
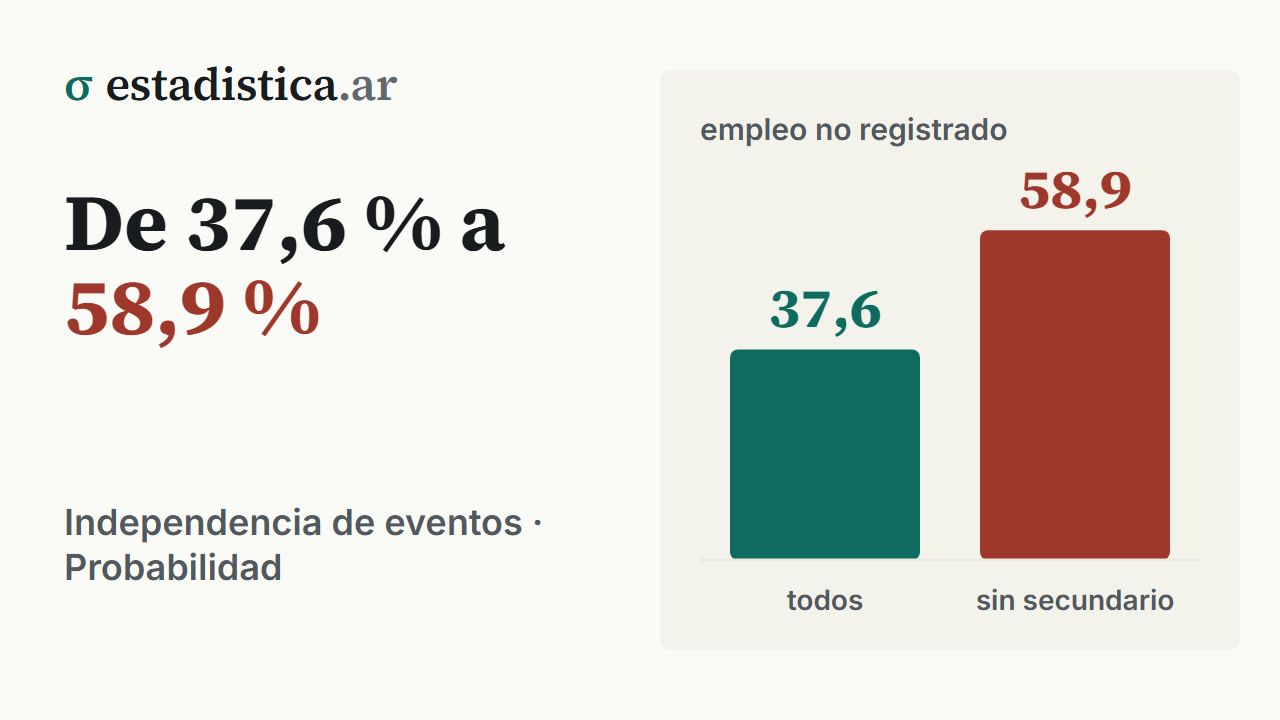
Se compara la conjunta observada con el producto de las marginales, y hay que hacerlo en todas las celdas, no en una:
| Celda | Observado | Esperado si fueran independientes | Razón |
|---|---|---|---|
| Sin secundario, no registrado | 0,1494 | 0,0954 | 1,57 |
| Sin secundario, registrado | 0,1042 | 0,1581 | 0,66 |
| Con secundario, no registrado | 0,2271 | 0,2810 | 0,81 |
| Con secundario, registrado | 0,5194 | 0,4655 | 1,12 |
3 · Independientes no es excluyentes
Vale repetirlo porque es la confusión más persistente del módulo:
| Excluyentes | Independientes | |
|---|---|---|
| Si ocurre | es imposible | no cambia |
| Regla | se suman | se multiplican |
Dos eventos excluyentes con probabilidad positiva son fuertemente dependientes: saber que ocurrió uno descarta por completo al otro. , lejos de .
4 · Independencia de a pares no alcanza
Para más de dos eventos, la definición exige que el producto se cumpla para todos los subconjuntos, no solo para los pares:
y además las tres igualdades de a pares. Que una cosa no implique la otra se ve en un ejemplo mínimo. Se tiran dos monedas y se definen:
| Par | Conjunta | Producto | |
|---|---|---|---|
| y | 0,25 | 0,25 | independientes |
| y | 0,25 | 0,25 | independientes |
| y | 0,25 | 0,25 | independientes |
| Los tres | 0,25 | 0,125 | no |
5 · El supuesto más frágil de la Estadística
Casi todas las fórmulas del curso —el error estándar , la binomial, la prueba t, la regresión— suponen observaciones independientes. Y es el supuesto que más se viola en la práctica:
- Personas del mismo hogar. Comparten ingreso, barrio y hábitos: sus datos no son independientes.
- Mediciones repetidas del mismo sujeto.
- Alumnos del mismo curso, pacientes del mismo hospital. El efecto del docente o del servicio los vuelve parecidos entre sí.
- Series de tiempo. El valor de un mes está correlacionado con el anterior.
- Muestreo por conglomerados. Que es justamente el diseño de la EPH.
Cuánto, en la propia EPH. Si se remuestrean viviendas completas en lugar de personas sueltas, con los mismos ponderadores, el error estándar crece 1,09 veces para la proporción de empleo no registrado de la sección 2, 1,14 para la de menores de 15 años y 1,22 para la de quienes terminaron el secundario. Es un piso, porque la base pública no identifica el radio censal, el otro nivel de agrupamiento del diseño.
Eso es la dependencia sola. El diseño completo suma los ponderadores desiguales, y entonces los errores estándar reales llegan a ser el doble de los que da la fórmula simple: un intervalo calculado con ella tiene la mitad del ancho que le corresponde. Ver el efecto de diseño.
La solución no es ignorarlo: hay modelos —mixtos, ecuaciones de estimación generalizadas, errores estándar robustos por conglomerado— construidos precisamente para eso.
6 · Errores frecuentes
- Confundir independiente con excluyente.
- Multiplicar probabilidades de eventos dependientes. Corresponde la regla del producto general, con la condicional.
- Suponer independencia por defecto. Es un supuesto fuerte: hay que justificarlo con el diseño del estudio.
- Creer que “no correlacionados” implica independientes. La correlación solo mide relación lineal.
- Verificar la independencia en una sola celda de la tabla. Tiene que cumplirse en todas.
- Verificar solo los pares cuando hay tres o más eventos.
- Tratar como independientes a personas del mismo hogar o del mismo curso.
7 · En el software
Con el archivo de personas de la EPH, usu_individual_T126.txt, y el universo
del caso: asalariados de 18 años o más con dato de descuento jubilatorio y nivel
educativo del 1 al 6. Las proporciones van ponderadas; la prueba, no (ver la
nota de abajo).
# R
ind <- read.table("usu_individual_T126.txt", sep = ";", dec = ",", header = TRUE)
d <- subset(ind, ESTADO == 1 & CAT_OCUP == 3 & CH06 >= 18 &
                 PP07H %in% 1:2 & NIVEL_ED %in% 1:6)
d$secundario <- ifelse(d$NIVEL_ED >= 4, "con", "sin")
d$registrado <- ifelse(d$PP07H == 1, "sí", "no")

obs <- prop.table(xtabs(PONDERA ~ secundario + registrado, data = d))
esp <- outer(rowSums(obs), colSums(obs))        # producto de las marginales
round(obs - esp, 4)                             # ±0,0539 en las cuatro
round(obs / esp, 2)                             # las razones: 1,57 ... 0,66

chisq.test(table(d$secundario, d$registrado), correct = FALSE)   # 866, 1 gl
# Python
import numpy as np
import pandas as pd
from scipy import stats
ind = pd.read_csv("usu_individual_T126.txt", sep=";", decimal=",", low_memory=False)
d = ind[(ind.ESTADO == 1) & (ind.CAT_OCUP == 3) & (ind.CH06 >= 18)
& ind.PP07H.isin([1, 2]) & ind.NIVEL_ED.between(1, 6)]
sec, reg = d.NIVEL_ED >= 4, d.PP07H == 1
obs = pd.crosstab(sec, reg, values=d.PONDERA, aggfunc="sum", normalize="all")
esp = np.outer(obs.sum(axis=1), obs.sum(axis=0))
print((obs - esp).round(4)) # ±0,0539 en las cuatro
print((obs / esp).round(2)) # las razones
chi2, p, gl, _ = stats.chi2_contingency(pd.crosstab(sec, reg), correction=False)
print(chi2, gl) # 866, 1Excel: observados (proporciones ponderadas) en B2:C3
marginales D2 =SUMA(B2:C2) B4 =SUMA(B2:B3) y así con las otras
esperado F2 =$D2*B$4 copiado a F2:G3
razón =B2/F2
prueba =PRUEBA.CHICUAD(conteos observados; conteos esperados)
con conteos sin ponderar, no con proporciones
SPSS: SELECT IF ESTADO = 1 AND CAT_OCUP = 3 AND CH06 >= 18
AND ANY(PP07H, 1, 2) AND RANGE(NIVEL_ED, 1, 6).
COMPUTE sec = NIVEL_ED >= 4.
COMPUTE reg = PP07H = 1.
CROSSTABS /TABLES = sec BY reg
/STATISTICS = CHISQ /CELLS = COUNT EXPECTED.Herramientas de este tema
- CalculadoraProbabilidad y teorema de Bayes
Seguir leyendo
Bioestadística · Azar y modelos · 106 de 330
Estadística para Economía y Administración · Azar y modelos · 109 de 318
Probabilidad y Estadística · Azar y modelos · 88 de 302
Estadística para Ciencias Sociales · Azar y modelos · 96 de 288
Estadística para la tesis · El análisis · 124 de 233
Cómo citar: Montivero, J. L. (2026). Independencia de eventos. estadistica.ar. https://estadistica.ar/conceptos/independencia-de-eventos
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Independencia de eventos. estadistica.ar. https://estadistica.ar/conceptos/independencia-de-eventos
BibTeX
@misc{estadistica_ar_independencia_de_eventos,
  author       = {Montivero, Jorge Luis},
  title        = {{Independencia de eventos}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/independencia-de-eventos}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-11-18}
}
Última actualización: 18 de noviembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.