estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/estandarizacion-indirecta
Estandarización indirecta y razón de mortalidad estandarizada
El método para cuando las tasas específicas no son confiables: se aplican las tasas de referencia a la población propia y se compara lo observado con lo esperado.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Cuándo se usa
Cuando la población estudiada es chica y sus tasas específicas por edad son demasiado inestables para usarlas directamente.
No hace falta bajar a un departamento para verlo. En 2022, Tierra del Fuego tuvo 2 defunciones en uno de sus grupos de edad, y Catamarca 9 en el de 10 a 14 años: con una muerte más o una menos, la tasa de ese grupo cambia entre un 10 % y un 50 %.
La indirecta invierte la operación: usa las tasas de referencia —estables, calculadas sobre las casi 400.000 defunciones del país, sin ningún grupo de edad con menos de 900— y las aplica a la estructura de la población chica.
2 · El método
Paso 1. Tomar las tasas específicas por edad de la población de referencia.
Paso 2. Aplicarlas a la población de estudio para obtener los casos esperados:
Paso 3. Comparar con los casos observados:
3 · Cómo se lee la SMR
La razón de mortalidad estandarizada —standardized mortality ratio— es un cociente, no una tasa.
| SMR | Significa |
|---|---|
| 1,00 | la mortalidad observada es la esperada |
| 1,25 | 25 % más muertes de las esperadas |
| 0,80 | 20 % menos |
Cuando el evento no son muertes sino casos nuevos —de cáncer, de una enfermedad de notificación— el mismo cociente se llama razón de incidencia estandarizada (RIE, o SIR en inglés). La sigla en castellano de la de mortalidad es RME.
4 · Con las defunciones de 2022
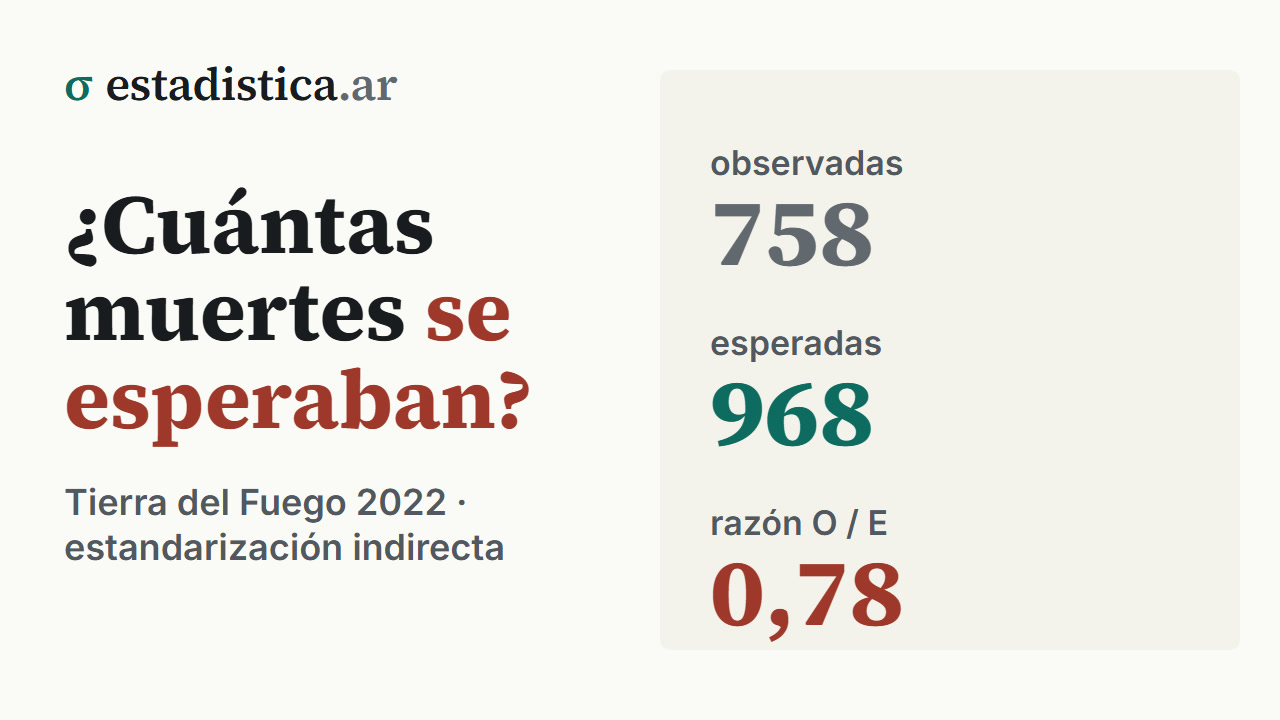
Aplicando a cada jurisdicción las tasas por edad del país, y comparando lo observado con lo esperado:
| Jurisdicción | Observados | Esperados | SMR | IC 95 % |
|---|---|---|---|---|
| Tierra del Fuego | 758 | 968 | 0,78 | 0,73 – 0,84 |
| Ciudad de Buenos Aires | 33.318 | 40.420 | 0,82 | 0,82 – 0,83 |
| Catamarca | 3.182 | 3.168 | 1,00 | 0,97 – 1,04 |
| Buenos Aires | 157.331 | 155.505 | 1,01 | 1,01 – 1,02 |
| Misiones | 9.455 | 7.844 | 1,21 | 1,18 – 1,23 |
| Chaco | 9.895 | 7.346 | 1,35 | 1,32 – 1,37 |
Chaco, en cambio, tuvo 2.549 muertes más de las esperadas, y CABA 7.102 menos. Esas diferencias absolutas son, muchas veces, más comunicables que cualquier tasa: no hablan de “por mil” sino de personas.
5 · De la SMR a una tasa
La SMR es un cociente, pero se la puede llevar a la escala de una tasa multiplicándola por la tasa bruta de la referencia:
Con Catamarca: por mil, lo mismo que da la estandarización directa con la población argentina como estándar: coinciden hasta el tercer decimal. Es el número que se publica cuando se quiere una tasa comparable y no un cociente.
6 · Qué datos necesita cada método
| Directa | Indirecta | |
|---|---|---|
| Tasas específicas del estudio | necesarias | no |
| Estructura del estudio | sí, dentro de las tasas | necesaria |
| Tasas específicas de referencia | no | necesarias |
| Eventos totales del estudio | no | necesarios |
No es la única salida. Con pocos casos también se pueden acumular varios años, suavizar las tasas con métodos bayesianos o modelar los conteos con una regresión de Poisson que incluya la edad. Y la indirecta no corrige el subregistro: si faltan defunciones en el total, la SMR sale baja.
7 · Su límite
Las SMR de distintas poblaciones no son estrictamente comparables entre sí.
Cada una se calculó con los casos esperados según su propia estructura, así que dos SMR usan ponderaciones distintas. Comparar una SMR de 1,20 con otra de 1,10 supone implícitamente que las estructuras son parecidas.
Cada SMR sí es comparable con la referencia, que es para lo que está pensada: “este departamento tiene un 20 % más de mortalidad que la esperable según el patrón provincial”.
8 · Dónde se usa
- Mortalidad de áreas chicas: departamentos, municipios, barrios.
- Salud ocupacional: mortalidad de un grupo de trabajadores contra la población general.
- Vigilancia epidemiológica: detectar zonas con exceso de casos.
- Evaluación de servicios: mortalidad hospitalaria ajustada por la gravedad de los pacientes.
9 · Errores frecuentes
- Comparar SMR entre poblaciones como si fueran tasas estandarizadas directas.
- Interpretar la SMR como una tasa. Es un cociente sin unidades.
- Reportarla sin intervalo de confianza, sobre todo con pocos casos.
- Confundir la escala: 1,25 y 125 son lo mismo.
- Leer una SMR alejada de 1 como hallazgo cuando su intervalo contiene al 1.
- Usar una referencia inadecuada, muy distinta de la población estudiada.
- Mapear SMR crudas de áreas chicas sin ningún suavizado. Lo habitual es el bayesiano empírico o el modelo de Besag, York y Mollié, que acercan cada SMR a la de sus vecinas en proporción a lo poco que dicen sus propios casos.
- Incluir en la referencia a una población que pesa mucho en ella, sin advertir que eso acerca su SMR a 1.
10 · En el software
El proyecto descargable de estandarización directa trae las defunciones y la población de 2022 por jurisdicción y grupo de edad, con el cálculo completo de la indirecta en R y en Python.
# R — defunciones 2022 por jurisdicción y edad, del descargable del sitio
library(dplyr)
zip <- tempfile(fileext = ".zip")
download.file("https://estadistica.ar/descargas/estandarizacion.zip", zip, mode = "wb")
d <- read.csv(unz(zip, "estandarizacion/datos/mortalidad-2022.csv"))

# Paso 1: tasas específicas de la referencia, el total del país
ref <- d |> group_by(grupo_edad) |>
  summarise(tasa_ref = sum(defunciones) / sum(poblacion))

# Pasos 2 y 3: esperados, observados y SMR
smr <- d |> left_join(ref, by = "grupo_edad") |>
  group_by(jurisdiccion) |>
  summarise(O = sum(defunciones), E = sum(poblacion * tasa_ref)) |>
  mutate(smr = O / E,
         inf = qchisq(.025, 2 * O) / (2 * E),          # IC exacto de Poisson
         sup = qchisq(.975, 2 * O + 2) / (2 * E))
smr |> filter(jurisdiccion == "Catamarca")
#> 3182 3168.3 1.004 0.970 1.040

# Prueba de SMR = 1: da el mismo intervalo y el p
poisson.test(3182, 3168.3)                             # p = 0,80

# Llevarla a escala de tasa: SMR por la bruta de la referencia
1.004322 * sum(d$defunciones) / sum(d$poblacion) * 1000   # 8,69

# Con paquete: epitools::ageadjust.indirect(count, pop, stdcount, stdpop)
# Python — el mismo cálculo
import io
import urllib.request
import zipfile
import pandas as pd
from scipy import stats
pedido = urllib.request.Request("https://estadistica.ar/descargas/estandarizacion.zip",
headers={"User-Agent": "Mozilla/5.0"})
z = zipfile.ZipFile(io.BytesIO(urllib.request.urlopen(pedido).read()))
d = pd.read_csv(z.open("estandarizacion/datos/mortalidad-2022.csv"))
ref = d.groupby("grupo_edad")[["defunciones", "poblacion"]].sum()
d["esperados"] = d["poblacion"] * d["grupo_edad"].map(ref.defunciones / ref.poblacion)
t = d.groupby("jurisdiccion")[["defunciones", "esperados"]].sum()
O, E = t["defunciones"], t["esperados"]
t["smr"] = O / E
t["inf"] = stats.chi2.ppf(0.025, 2 * O) / (2 * E)
t["sup"] = stats.chi2.ppf(0.975, 2 * O + 2) / (2 * E)
t.loc["Catamarca"] # 3182 3168,3 1,004 0,970 1,040
# p de SMR = 1 duplicando la cola menor: 0,81 (R usa otro criterio y da 0,80)
o, e = 3182, 3168.3
2 * min(stats.poisson.cdf(o, e), stats.poisson.sf(o - 1, e))Excel: esperados =SUMAPRODUCTO(tasas_ref; poblacion_estudio)
SMR =O/E
IC 95 % =INV.GAMMA(0,025; O; 1)/E y =INV.GAMMA(0,975; O+1; 1)/E
SPSS: no trae un procedimiento: se agregan los esperados con
Datos › Agregar, y el intervalo con Transformar › Calcular:
COMPUTE inf = IDF.CHISQ(0.025, 2*O) / (2*E).
COMPUTE sup = IDF.CHISQ(0.975, 2*O + 2) / (2*E).Herramientas de este tema
- CalculadoraEstandarización de tasas
- PlantillaEstandarización directa de tasas
- ScriptEstandarización de tasas
Seguir leyendo
Bioestadística · El dato en contexto · 87 de 330
Probabilidad y Estadística · El dato en contexto · 80 de 302
Cómo citar: Montivero, J. L. (2026). Estandarización indirecta y razón de mortalidad estandarizada. estadistica.ar. https://estadistica.ar/conceptos/estandarizacion-indirecta
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Estandarización indirecta y razón de mortalidad estandarizada. estadistica.ar. https://estadistica.ar/conceptos/estandarizacion-indirecta
BibTeX
@misc{estadistica_ar_estandarizacion_indirecta,
  author       = {Montivero, Jorge Luis},
  title        = {{Estandarización indirecta y razón de mortalidad estandarizada}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/estandarizacion-indirecta}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-11-16}
}
Última actualización: 16 de noviembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.